文章
文章
新模型、新工具每天都在发布,我只问一件事:它在生产环境里站得住吗?这里写数据、AI 与可追溯性,写给真正要把它们跑起来的人。
让分析 agent 先过考试:拆开 Data Culture 在 dbt 上的评测框架
Data Culture 没换模型,把一个电商分析 agent 的准确率从 0% 做到 94.7%,靠的是一层层加进去的上下文和一套按结果判分的考卷。我对照他们开源的 agent-trust-for-dbt 仓库,把架构拆成五层画出来:数据底座、agent 读的契约、只读的 agent、三关确定性比对加 LLM 裁判,以及一份讲人审的方法文档,最后讲哪些可以直接借、哪些要改。
在 Entire 上走一遍 Trail:agent 在哪几步介入,人在哪几步拍板
前 GitHub CEO Thomas Dohmke 的 Entire 10 月 26 日推出面向“人加 agent”的 Git 托管平台,用 Trail 代替 PR:每次推送都由评审 agent 重新打分,再由闸门、CI 和人一起决定能不能合并。我照着官方文档把一次改动从开票到合并走了一遍,画清楚每一步谁在动手。
Liquid Clustering 号称四类负载赢三类,其实只测了三类
一篇 InfoQ 基准文章在 5,000 万行数据上比较 Delta Lake 的分区、ZOrder 和 Liquid Clustering。我把三类查询的耗时和读取量画成图,指出第四类“全表聚合”的数字和第二类一模一样,再用一张表对比三种布局各自的强项和弱项。
给 agent 加记忆之前,先量一量原始记录加检索的账
两篇 10 月的论文把复杂的 agent 记忆系统和“存原始对话、检索加重排”的朴素做法放在一起比,后者七组设置赢了六组,写入时间只有几十分之一。我的建议是在场景早期先搭这个基线,把写入成本、准确率和丢掉的证据量清楚,再决定记忆架构。
Claude 写的字里有了水印:欧盟要求什么,水印又能证明什么
为满足欧盟 AI 法案,Anthropic 从 8 月起给新 Claude 模型的文字输出加上看不见的水印。我先讲清这件事和水印的原理,再拆开法案第 50 条对提供方和发布方的要求,最后说明水印能回答什么、回答不了什么。
仪表板会被一个写总结的 agent 取代吗?Brilliant Earth 已经走了一半
珠宝商 Brilliant Earth 把分析工具搬进 Snowflake,100 多名门店用户离开旧 BI,周报由 LLM 根据代码算好的数字来写。我借这个案例回答一个问题:数据可视化作为管道的末端,会不会被一个负责总结的 agent 取代?
一个周末搬走 500GB:Shipsidekick 从 Neon 换到 ClickHouse Postgres 的前后对比
物流 SaaS Shipsidekick 把 Postgres 从 Neon 搬到 ClickHouse 托管 Postgres,一个周末完成切换。我把迁移前后的核心参数和迁移步骤画出来,拆开看哪些提升来自架构、哪些来自更大的机器,以及原文没给的那张账单。
dbt State 永久免费:每月 1,000 个 DATT 值 94 美元,省更多要看仓库账单
dbt Labs 宣布 dbt State 对自托管用户永久免费,每月 1,000 个 DATT。我先讲清它怎么决定跳过、克隆还是重建,再分生产、预发、开发三种环境说用法,最后算一算免费额度到底值多少钱。
决策模型进了数仓,最该借鉴的是它的问法
Snowflake 10 月 19 日发布低延迟决策模型 Decision Fast(私有预览),在 SQL 里一次调用就能给出带概率的分类、打分和路由答案。我把它的设计拆成三步画出来,再说企业在数仓里用这类模型,放在哪里最省钱、最提效。
让 agent 修失败的管道:照着 Snowflake 的 16 分钟流程搭一遍
Snowflake 数据团队用 agent 修复失败的数据管道,从发现故障到提交待审 PR 平均不到 16 分钟。我把这套做法拆成一份能照着做的教程:要先具备哪些前提,怎么一步步搭,优势在哪,出了问题怎么回滚、代价多大,还有原文没交代的空白。
Databricks 多语句事务 GA:用两个客户案例看它到底省了什么
Databricks 的多语句、多表事务 10 月 16 日正式可用。原文只用两句引语带过客户案例,我把 Fivetran 和 Accolade 的场景拆开讲:以前一次变更分几步写、中途断掉会留下什么,放进一个事务后变了什么,再画出一次事务从 BEGIN 到 END 的路径。
Atlassian 每天 440 亿条安全日志,摄取成本是怎么降掉 80% 的
Atlassian 把二十年收购留下的杂乱安全日志统一成 OCSF,放进 Databricks 湖仓,厂商称摄取成本降了 80%;我按数据走的顺序拆开这套方案的七个做法,并说明 80% 这个数在三份材料里的不同说法。
Snowflake 的 Postgres 镜像正式可用:和 Databricks Lakebase 并排比一比
Snowflake Postgres 的数据镜像 10 月 15 日 GA,我把它和 Databricks Lakebase 放进一张表,比机制、延迟、事务性、变更流和反向同步:Snowflake 的一致性更完整,但"几秒内"和"事务完整"要二选一;Databricks 两个方向都有,回程那条还在预览。
想跑动车,先铺铁轨
Snowflake 的制造业调研说,41% 的制造商卡在试点,一半还把电子表格当主要数据层。欧盟、美国、中国的数字口径不同,指向同一件事:AI 是动车,数据基础是铁轨,铁轨没铺好,车再快也开不出站。
把过滤脚本换成裁判模型之前,先问三件事
Databricks 允许在 Unity Gateway 的服务策略里用 OpenJev 小模型当裁判。我喜欢用决策模型替代过滤脚本这个方向,但在强审计场景里,置信度、能否重放、回退成本这三件事要先想清楚。
GDPR 管得再严,个人也看不见数据到底有没有被保护
IAPP 一篇观点文章问,欧盟监管在无法趋同时,可预测与一致能不能补位。我的看法是规则可以很严,但能核查的只有监管机构和企业,个人手里只有一纸声明。
要 100% 准确的场景,Agent 是怎么被一层层关起来的
金融监管报送要求零差错,一篇 AICon 演讲的整理给出了一套 Agent 约束体系。这套做法逻辑成立,但它靠的是加约束换准确,数据生成阶段的非标问题还留在上游。
通用模型写得出管道,算不清账单
Josh Wills 说代理会写出结果正确却很烧钱的数据管道。我认为问题出在通用模型缺少这一行的反馈,数据工程等的是一个懂行的专家代理。
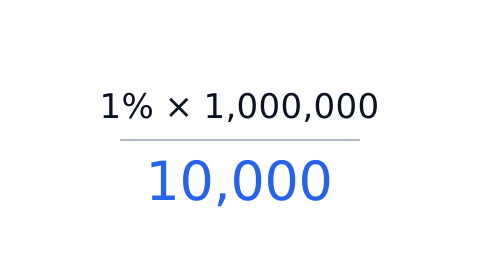
d1 一次判断只要 8 毫秒,错的那几次谁来兜底
Liquid AI 开源了不生成文字、直接给出判断的小模型 d1。我期待这类模型,但放进生产环境之前,要先算清它的错误率乘以调用量。