d1 一次判断只要 8 毫秒,错的那几次谁来兜底
8 毫秒给出一个判断
10 月 7 日,Liquid AI 在 Hugging Face 放出了两个开放权重的决策模型:d1-3B 和实验性的 d1-omni-600M。1决策模型不写文字。你给它一个问题和一组固定选项,它做一次前向计算,直接给出答案。厂商称 d1-3B 在 RTX 4090 显卡上回答一个问题约 8 毫秒,在 Jetson Orin Nano 这种边缘小板子上约 50 毫秒。1回答是非题时,它给出“是”的概率;回答选择题时,它给出选中的选项、置信度和每个选项的概率。2
准确率方面,厂商称 d1-3B 在 Decision Index v0.2.1 公开集上得 48.57 分,是 10B 参数以下的最高分,和体量约 12 倍的 Decider 35B-A3B 持平;在 7 个公开基准上平均 82.9 分。1
TypeSafe AI 的 Jev 走的是同一条路:输出带概率的结构化判断,厂商称端到端响应在 70 到 500 毫秒之间,但没有公布公开基准成绩。4
错误率要乘以调用量
我对 d1 的第一个顾虑,和看到 Jev 时一样:这么小的模型,判断能有多准?
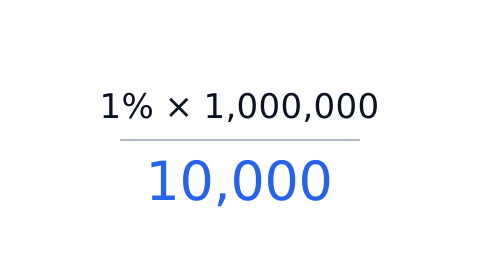
先把账算清楚。这类模型进生产环境,是因为它能用很低的成本处理海量的分类、审核和控制请求。也正因为调用量大,错误率必须和调用量放在一起看:每天的错误总数,等于错误率乘以调用次数。假设一条审核管道每天做 100 万次判断,准确率 90% 意味着每天 10 万次错放或错拦;就算提到 99%,每天仍有 1 万次。准确率每提高一点都很值钱,但错误的绝对数量很难降到可以忽略。所以比起问“准确率够不够高”,更该问三件事:每天错多少次,每次错的代价有多大,业务能承受多少。
还要找对参照物。现在的流程同样会出错:人工审核员会疲劳,大模型会编造,而且都更贵。小模型值不值得用,要看它在同一批数据上比现有方案多错还是少错,以及错的那部分能不能被拦下来。
我的顾虑里,有一部分能在厂商自己的数据里找到依据。参数量少,能装下的知识就有限:模型卡上,d1-3B 在 Decision Index 知识类只得 23.8 分。2上下文的情况更复杂。它支持 32K token,2但输入一长,代价就很明显:一段 3.4K token 的状态描述,就让单次延迟在 RTX 4090 上从约 8 毫秒升到 102 毫秒,在 Orin Nano 上升到 1.64 秒。1长输入下准确率会不会下降,厂商没有给数据,这一点只能存疑。
这些数字都来自厂商,生产环境里能不能站住还没人验证过。5模型卡没有局限性章节,也没有校准误差指标,“校准”只出现在描述里。2我期待这样的小模型,但真正部署之前,我会把它当作一个需要先验证的组件。
上线之前我会做的四件事
如果要用 d1,下面四件事我会先做完。
第一,在自己的数据上量错误率,换算成“每天错多少次”,再问业务能不能接受这个数。公开基准的平均分代表不了你的场景。
第二,用好它给出的概率。官方文档把模型路由和级联列为用途,却没给阈值、拒答,或转交大模型和人工的指引。3这部分要自己设计:置信度高的直接执行,低的交给更大的模型或人工复核。
第三,先让它做可撤回的动作。打标签、排优先级,错了可以改;删内容、拦交易、发控制指令,错一次的代价要单独算。
第四,给它留一条越用越准的路。通用的决策模型不了解你的业务,部署到具体场景时,最好能用自己的数据对它微调。d1 的权重是开放的,2技术上可以这样做,但官方文档目前没有给出微调方法。3比较实际的做法是把复核环节用起来:低置信度的请求交给人工复核,复核结果就是带标签的业务数据;积累到一定量后拿来微调,再在同一套数据上重新量一次错误率。这样模型会越用越贴合你的场景,每一次改进也都有数字可查。
小而快的决策模型会让很多原本用不起大模型的场景用上 AI。它越便宜,调用量就越大,错误的总数也会跟着涨。上线之前,先算错误率乘以调用量。
参考
- Open d1: Edge decision models for text, vision, and audio, Liquid AI
- LiquidAI/d1-3b model card, Hugging Face
- Decision models, Liquid AI Docs
- Introducing System One Models & Jev, TypeSafe AI
- Liquid AI releases open d1 models for multimodal edge decisions, RuntimeWire
评论
匿名评论审核后显示,用 GitHub、X、Facebook 登录后直接显示。邮箱不公开,只用于回复通知。
评论暂时加载不出来,稍后再试。