要 100% 准确的场景,Agent 是怎么被一层层关起来的
目录
有些场景,97% 的准确率等于不能用
InfoQ 中文在 10 月 10 日整理了中软融鑫总工程师于浩军在 AICon 全球人工智能开发与应用大会(深圳)上的演讲,题目是金融监管领域的 Harness 实践。1演讲讲的是金融机构向监管报送数据时,怎么让 Agent 稳定地干活。我读完的第一感受是,这是目前我见过的、针对“高风险并且强审计”场景提出的质量很好的 Agent 架构方案之一。
先说清楚这类场景的特点,因为它决定了后面所有的设计。作者给出的数字很直观:一张报表可能涉及 100 到 500 个指标,数据要经过 15 层以上的加工才到报表上,口径每年至少调整一次,变动幅度约 30%。1他明确说,97% 的准确率不够,要求是 100%,错了会被罚,行业上半年的罚款已经到了数亿元的量级。1这些数字都是演讲者的说法,我没有办法独立核实,但场景的性质不难理解:口径写在文件里,每年会变,错一个数就要担责,事后还得说清每个数从哪来。
不止金融:强审计的行业都要求“每一步都能说清”
金融不是唯一这样的行业。换到药品行业,美国联邦法规 21 CFR 11.10 要求电子记录系统必须经过验证,能发现无效或被改动过的记录;审计追踪要由系统自动生成、带时间戳,记录每一次创建、修改和删除,并且“记录的修改不得掩盖之前记录的信息”。4换到航空维修,14 CFR 43.9 规定每条维修记录要写明做了什么、什么时候完成、谁做的,通过检验的还要有批准人的签字和证书号。5再看欧盟的 AI 法案,高风险 AI 系统必须在整个生命周期里自动记录事件,2并且要设计成人能够有效监督:能看懂它的能力和局限,能不采用或推翻它的输出,能让它停下来。3
这几份规定行业不同,要求却很像:过程要留痕,改动不能抹掉历史,关键判断要有人负责,系统要能被验证。一个会“自由发挥”的通用 Agent,和这些要求天然冲突。作者的做法,是从一开始就不让它自由发挥。
约束从数据和知识开始,一层层往外加
原文的架构分成两个地基和一个执行层。1第一个地基是知识库,放监管文件和内部业务口径,检索方式把向量检索、精确匹配和图谱三种结合起来,并且按 Agent 的职责范围切片,每个 Agent 只能看到自己该看的那部分。第二个地基是数据库,放明细、指标和报表数据,同时带着元数据、数据标准、密级和质量治理,访问受权限控制。
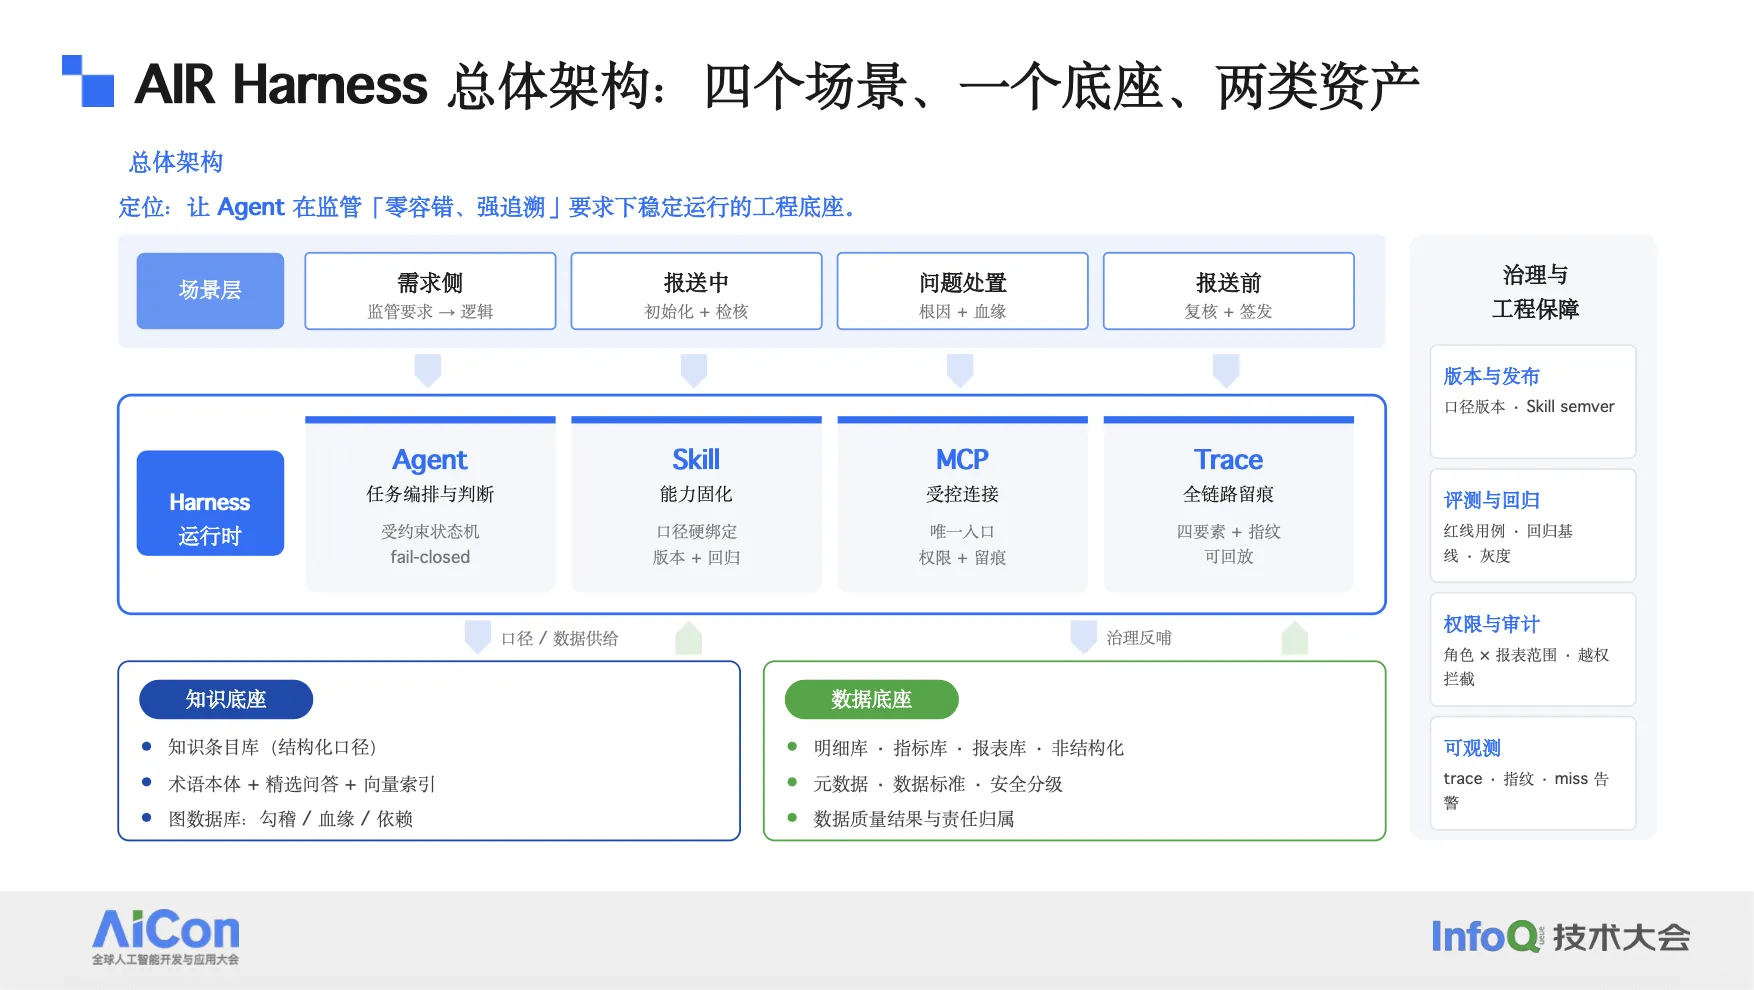
在这两个地基之上是执行层,包括任务编排、技能固化、受控的 MCP 连接和全程留痕。执行层对 Agent 的每一步循环加了五道控制。规划阶段,技能只能来自注册过的集合,并且必须产出结构化的计划。保护阶段,用动作白名单和模式校验拒绝越界操作。执行阶段,确定性的计算放进固定的 Python、Java 或 SQL 工具里,不让模型推理。检查阶段,进入下一步之前先校验契约和一致性。过程检查阶段,四个主要维度缺任何一个,这个状态就判为失败。1
在这五道控制之外,还有几条硬限制:动作空间是封闭的,没注册的技能和工具调用不了;有预算和步数上限,作者举的例子是预计 15 步的任务如果超过 30 步就中止;有三个人工节点,分别是口径确认、数据补全和最终签字;出错就停,不自己想办法继续。1作者还给了一个对照:不加约束时,币种本该有 5 种左右,模型却生成了 15 到 16 种。1
模型只做判断,计算和口径交给固定的代码
这套方案里我最认同的一条,是对模型职责的划分。原文列出的允许范围是意图识别、任务拆解、槽位抽取、技能路由、异常判断和文字识别;不允许做的是计算、汇总、口径判断,以及在受控接口之外检索知识。1
这条分界的道理,其实和前面几份规定是同一个。一个数是怎么算出来的,要能被复核、能被重放,而模型每次的推理过程都带着随机性,没有办法给出“同样的输入,必然同样的输出”。把计算放进固定代码,等于把“能不能被审计”这个问题,从一个很难回答的问题,变成一个可以逐行检查的问题。标题里的“口径只使用不理解”,说的也是这个思路:口径来自带版本的知识库条目,Agent 只能引用,不能自己解释。
技能的规格也是按这个思路定的。每个技能必须带口径引用,计算在模型之外,输入输出有契约和枚举类型,版本和知识条目绑定,还附有回归用例。原文把技能分为口径类、计算类、校验类、追溯类、数据重放类和输出类,覆盖了从口径解读到质量报告的整条链路。1
一趟报送怎么走完,错了怎么停
原文用一次完整的报送演示了这些约束怎么配合,共六步:接收任务并拆成一个个指标;通过 MCP 从知识库取口径;经受控通道取数;做对账校验;遇到异常时沿血缘追溯并给出整改建议;最后产出复核报告。1
上线之前还有三道关。第一道是红线规则:口径含糊、跨表对不上、出现极端值或空值,都会直接拦住发布。第二道是用历史数据做回归,每个用例要跑 5 到 6 次,历史测试覆盖 5 期和 10 期。第三道是灰度并行:连续 3 到 4 轮没有问题才能进生产,并且要和人工流程并行跑 3 到 5 个月。1作者还提到,他个人每月在 token 上的花费大约是 3 万到 4 万元,这是他自己的数字,它说明约束并不等于便宜。1
加约束换来了准确,但上游的非标问题还在
这套方案的逻辑我认为是成立的。它从数据源开始,一级一级加约束:技能必须注册,动作必须在白名单里,计算必须在固定代码里,每一步要过校验,关键节点要有人。目的很清楚,就是尽量避免非标准的数据源,也避免 Agent 本身被污染。
不过我想多说一句,这个思路的本质是“剔除非标原料”,用增加约束去换取准确性。它拦住的是进入链路之后的问题,并没有从根本上解决数据在生成阶段就可能出现的非标问题。如果上游第一次写入的数据就不标准,后面再多的校验,也只能是发现它、拦住它,没法让它变标准。
当然,这一点我是在鸡蛋里挑骨头。链路有 15 层以上,作者在中后段、在今天的技术条件下,能给出这样一套完整的方案,已经非常不容易了。上游怎么办,很可能不是 Agent 这一层能回答的问题,而是数据生产方、业务系统和数据标准要一起回答的问题。
做强审计的 Agent 系统,可以照这张清单检查
把原文的做法压成一张检查清单,换到别的强审计场景也适用:
- 哪些步骤必须算准?把它们从模型里拿出来,放进可以逐行检查的固定代码。
- 技能和工具有没有注册表?没有注册的,能不能保证调用不了?
- 每一步输入输出有没有契约?进入下一步之前有没有校验?
- 有没有步数和预算的上限?超了是继续还是停?
- 出错时是自己想办法继续,还是停下来交给人?
- 关键判断(口径、数据补全、最终签字)有没有人工节点?
- 上线之前有没有历史回归和灰度并行?
- 上游的数据,是谁在保证它第一次被生成时就是标准的?
前七条,原文已经给出了做法。第八条,是这篇文章没有回答、也值得我们继续追问的问题。
参考
- 金融监管领域的 Harness 实践:让知识与数据驱动 Agent 稳定运行, InfoQ 中文
- Article 12: Record-Keeping (EU AI Act), artificialintelligenceact.eu
- Article 14: Human Oversight (EU AI Act), artificialintelligenceact.eu
- 21 CFR 11.10 Controls for closed systems, Cornell Law School LII
- 14 CFR 43.9 Content, form, and disposition of maintenance records, Cornell Law School LII
评论
匿名评论审核后显示,用 GitHub、X、Facebook 登录后直接显示。邮箱不公开,只用于回复通知。
评论暂时加载不出来,稍后再试。